

Wat is server-side tracking en hoe werkt het?
Server-side tracking is zo’n begrip dat je misschien al vaak voorbij hebt zien komen, maar waarvan je nooit precies hebt begrepen wat het nou eigenlijk betekent. Dat is ook niet zo gek, want de werking ervan wordt vaak onjuist uitgelegd. Hoogste tijd dus voor Victor, product-manager en developer bij Super Interactive, om er in te duiken.
In dit artikel leggen we stap voor stap uit hoe server-side tracking werkt, waarom organisaties het gebruiken en wat de belangrijkste voor- en nadelen zijn.

Wat is server-side tracking?
Om server-side tracking te begrijpen, helpt het om eerst het verschil tussen client-side en server-side helder te hebben. Met client-side bedoelen we wat er in de browser van de bezoeker gebeurt. Server-side betekent dat de verwerking plaatsvindt op een server waarop bijvoorbeeld een website, script of applicatie draait.
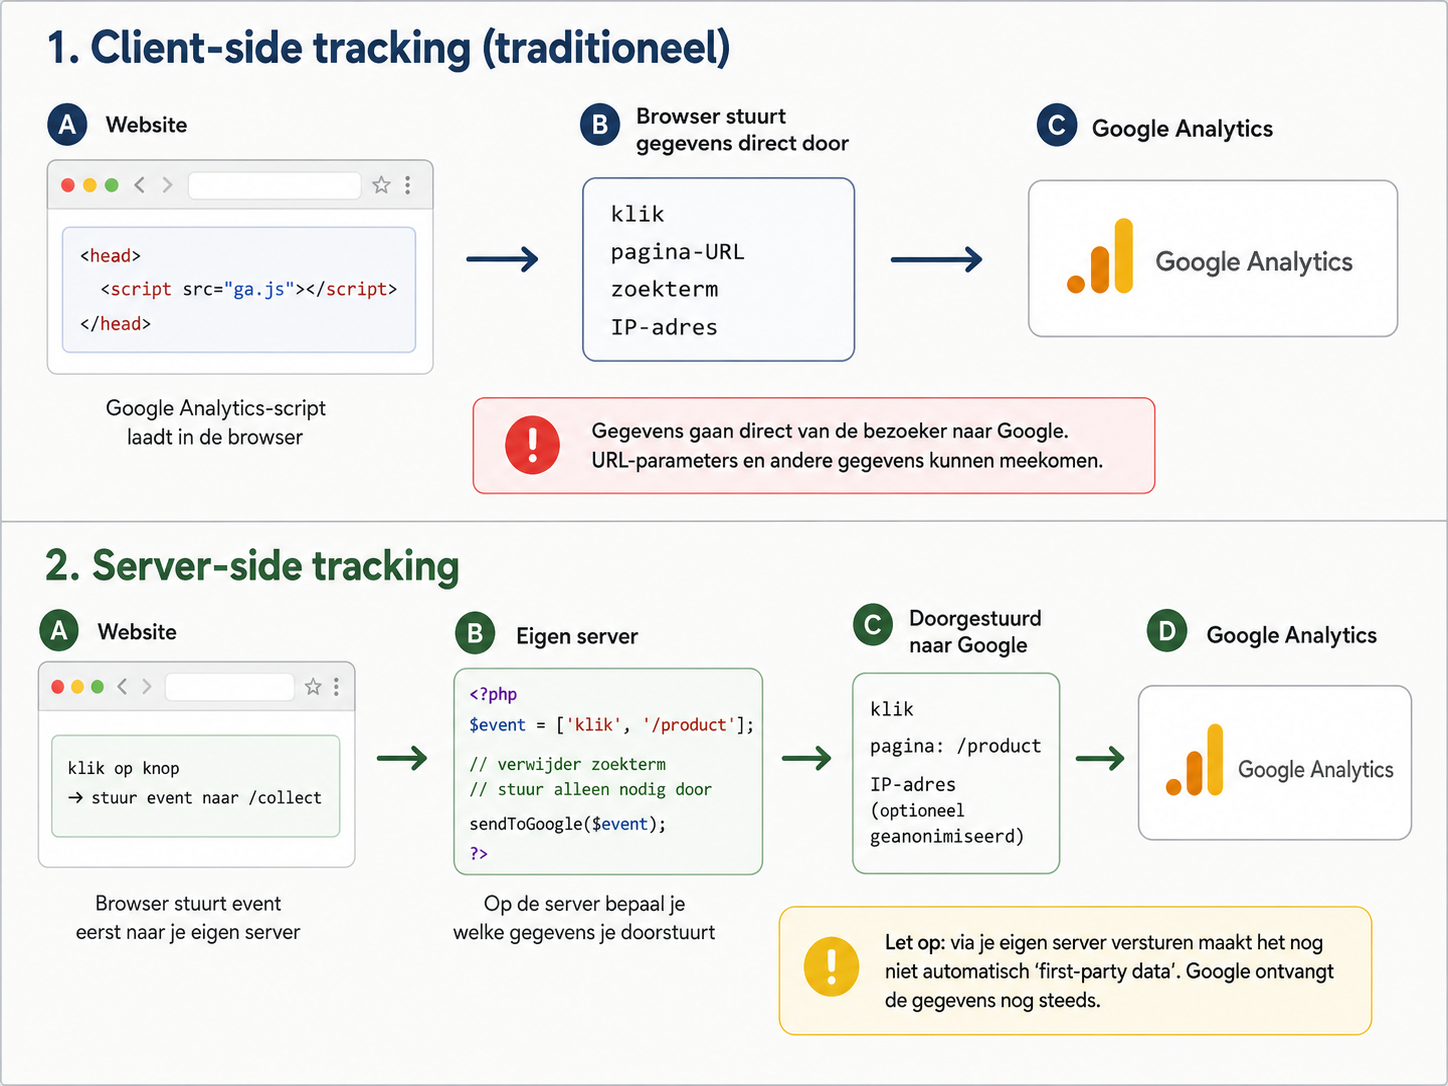
Traditioneel worden trackingscripts in de browser geladen. Zo'n script kan vervolgens rechtstreeks verbinding maken met de server van bijvoorbeeld Google Analytics of Meta om gegevens door te sturen.
Bij server-side tracking zit daar een extra stap tussen. Er draait nog steeds code in de browser, maar die stuurt de meetgegevens eerst naar een serveromgeving die onder jouw beheer valt. Die server verwerkt de gegevens en kan ze vervolgens doorsturen naar bijvoorbeeld Google of Meta.
Het voordeel hiervan is dat je eerst zelf controle krijgt over de gegevens. Je kunt bijvoorbeeld informatie verwijderen of aanpassen voordat deze naar een externe partij wordt doorgestuurd. Ook maakt de browser niet meer rechtstreeks voor iedere meting verbinding met de externe trackingpartij.
Dat betekent alleen niet dat de gegevens automatisch binnen je eigen organisatie blijven. Als je server ze vervolgens doorstuurt naar Google of Meta, komen ze daar alsnog terecht.
Hoe werkt server-side tracking technisch?
De meting uit de browser komt binnen op een eigen tracking-endpoint. Daar kun je bepalen wat er met de gegevens gebeurt voordat ze eventueel worden doorgestuurd naar andere systemen.
Je kunt data bijvoorbeeld controleren, aanpassen of filteren. Zo kun je URL-parameters met zoektermen verwijderen en alleen de paginanaam en het event naar Google Analytics sturen. Je kunt dezelfde gegevens ook gebruiken voor andere systemen, zoals Meta, LinkedIn of je eigen database.
Een veelgebruikte oplossing hiervoor is server-side Google Tag Manager. De servercontainer ontvangt de metingen, verwerkt ze volgens de ingestelde regels en bepaalt vervolgens welke gegevens naar welke partijen worden doorgestuurd.
Wat zijn de voordelen van server-side tracking?
Het belangrijkste voordeel van server-side tracking is dat je meer controle krijgt over welke data je verzamelt en doorstuurt. Je bepaalt dus zelf welke gegevens je verwijdert, aanpast, opslaat of doorstuurt naar partijen zoals Google of Meta. Daarnaast zijn er nog een aantal andere voordelen:
Performance: doordat je minder scripts van externe partijen in de browser hoeft te laden, kan de website sneller worden en hoeft de browser minder werk te doen.
Veiligheid: minder externe code in de browser betekent dat je meer controle hebt over wat er op je website wordt uitgevoerd.
Minder afhankelijkheid: je bent minder afhankelijk van hoe Google, Meta of andere partijen hun scripts en tracking in de browser hebben ingericht. Je bepaalt zelf hoe data binnenkomt, wordt verwerkt en eventueel wordt doorgestuurd.
Wat zijn de nadelen van server-side tracking?
Server-side tracking biedt meer controle, maar maakt de technische inrichting ook complexer. Je krijgt te maken met servers, datastromen en tagmanagement, waardoor de implementatie meer kennis vraagt dan traditionele client-side tracking.
Ook het opzetten en testen kost meestal meer tijd. Je controleert niet alleen of events goed binnenkomen, maar ook wat er onderweg met de gegevens gebeurt en waar ze uiteindelijk terechtkomen. Dat vraagt ook na de implementatie om onderhoud.
Daar kunnen extra kosten voor hosting, tooling of beheer bij komen. Belangrijker is dat je zelf meer verantwoordelijkheid krijgt over de data die je verwerkt. Je moet dus goed bepalen wat je verzamelt en wat je doorstuurt naar externe partijen. Server-side tracking maakt een implementatie niet vanzelf AVG-compliant.
Hulp nodig bij server-side tracking?
Ben je benieuwd of server-side tracking interessant is voor jouw organisatie? Meld je aan voor een kennismaking, dan kijken we samen welke data je echt nodig hebt en hoe je die zo gecontroleerd en privacyvriendelijk mogelijk verzamelt.

Victor
Developer